この記事の要約
- DB自作本「Database design and implementation」の1章〜3章までの感想と備忘録
- ファイルマネージャーをGoで実装
- DB自作するときに使うメソッド等や付随するCS知識の整理
はじめに
最近、CSの基礎知識不足が原因で様々な場面で弊害を感じています。例えば、技術書の理解に時間がかかったり、普段の開発でもベストプラクティスをなぞるだけになったり、概念的な理解に頼らざるを得なかったりと、技術的なトレードオフを厳密に判断できないなどです。この感覚を減らすために、自分が普段ブラックボックスとして利用している技術の自作を始めることにしました。
自作は「なぜその技術がその設計になったのか」や内部構造そのものを原理原則から理解する体験が得られるため、CSの基礎知識の習得に効果的とされています。
自作するものとしてよく挙がるのはOS、コンパイラ、ネットワークスタックなど他にも様々ありますが、本記事ではRDBMSを扱います。自作といっても、まずは教育用の完成されたものの写経がメインになるため温かく見守っていただけると嬉しいです。
本記事では、CS知識が乏しい人間がRDBMSの自作を始めてみた所感を共有します。RDBMSの自作に興味がある方の参考になれば嬉しいです。
進め方
書籍はDB自作界隈で定評のある「Database Design and Implementation」を参考に進めていきます。「Database design and implementation」はSimpleDBという、シンプルかつ完全に機能するDBシステムを章ごとに段階的に実装していく内容になっています。書籍ではJavaで実装されていますが、今回はGoで実装していきます。
こちらの書籍の自作してみた系の記事は既に多く存在し、お手本のリポジトリも多数ある。写経するだけである程度動くものができてしまうということもあり、ちゃんと理解するために暫定的に以下の方法で進めていくことにした。
流れ
各章、以下のステップで進めていく(実装は3章から開始)。
- インプットと概念理解
- データの流れと、なぜその設計が必要なのかなどを図などで整理
- 実装
- 先人たちのリポジトリから該当章時点のスナップショットや、当時のコミット・PRでの議論を参考に、実装したコードと比較し、理解を深める。
- その章が終わったら記事等でアウトプット
書籍中での実装の流れ
- ファイルマネージャー(3章)
- バッファマネージャー(4章)
- トランザクションマネージャー(5章)
- レコードマネージャー(6章)
- メタデータマネージャー(7章)
- クエリプロセッサー(8章)
- SQLパーサー(9章)
- プランナー(10章)
- DB接続インターフェース(11章)
- インデックスマネージャー(12章)
- ソート(13章)
- バッファの有効活用(14章)
- クエリオプティマイザー(15章)
1〜2章について
1章では、そもそもデータの管理にはどのような課題があり、それを解決するためにDBシステムはどのような機能を提供しなければいけないのかという話がメインでした。普段は自分がやりたいことが実現できそうなDBの機能を使っているだけでしたが、1章では目的や思想から向き合い、その機能がどういう目的で作られたのかという逆方向のアプローチでDBについて知ることができてとても面白かったです。
2章では、JDBCという「JavaアプリがDBシステムとやり取りする時に使う標準API」の仕組みや使い方、JDBC問わずAPI側が提供すべき機能といった設計思想、後半ではトランザクションの概要の話がメインでした。
3章
3章からはいよいよ実装フェーズに入りました。前半はディスクや、OSが提供する2つのインターフェース(ブロックレベルとファイルレベル)、そしてファイルの論理ブロックからディスクの物理ブロックへどのようにマッピングされるのかなどの基本概念を学びました。 後半では実際にSimpleDBのファイルマネージャーを実装しました。
概念整理
ファイルマネージャー
ファイルマネージャーとはDBエンジンがOSとやり取りを行う部分のことです。
SimpleDBが採用しているディスク上のデータを管理する手法
これは書籍が分かりやすいため引用します。
A compromise strategy is for the database system to store all of its data in one or more OS files, but to treat the files as if they were raw disks. That is, the database system accesses its “disk” using logical file blocks. The OS is responsible for mapping each logical block reference to its corresponding physical block, via the seek method.
直訳↓
妥協案として、データベースシステムがすべてのデータを1つ以上のOSファイルに格納しつつ、それらのファイルをまるで生のディスクであるかのように扱うという方法がある。つまり、データベースシステムは論理ファイルブロックを使用してその「ディスク」にアクセスする。OSは、シーク処理を通じて、各論理ブロック参照を対応する物理ブロックにマッピングする役割を担う。
一つ一つ整理してみましょう。
1. 妥協とは何のことか
これは、ブロックレベルインターフェースとファイルレベルインターフェースにはそれぞれメリデリがあり、両方の特徴を使うという意味での妥協を指しています。
ブロックレベル
メリット:
- 物理的なディスクブロックを完全に制御でき、パフォーマンスの最適化が可能。
- 直接ディスクの空き領域を管理するため、OSのファイルサイズ上限に縛られることなく巨大なテーブルを作成できたり、複数のディスクにデータを分散させることで読み書きを高速化したりが可能。
デメリット:
- 実装が複雑。
- ディスクをOSのファイルシステムを通さないRawディスクとしてフォーマットし、マウントする必要がある。
- データベース管理者がブロックアクセスパターンに関する広範な知識を持っている必要がある。
ファイルレベル
メリット:
- 実装が楽(物理的なディスクアクセスの複雑な詳細をOSに任せ、データベースシステムから隠蔽できる)。
デメリット:
- ブロックの境界の位置が把握できないため、データを効率的に整理・取得できない
- OSによるI/Oバッファの管理方法がデータベースクエリに適していない(4章の記事で詳細を記述)
2. この妥協案の何が嬉しくて何が辛いか
この妥協案は、前述したメリデリのうちブロックレベルインターフェースの以下の2つのメリットは享受できないものの、他をカバーできます。
- 物理的なディスクブロックを完全に制御でき、パフォーマンスの最適化が可能。
- 直接ディスクの空き領域を管理するため、OSのファイルサイズ上限に縛られることなく巨大なテーブルを作成できたり、複数のディスクにデータを分散させることで読み書きを高速化したりが可能。
3. この妥協案のSimpleDBでの挙動
DBサーバーのバッファ内論理オフセットでの読み書き
- ファイルマネージャー側で、論理ブロック(ファイルを一定サイズ(書籍では400バイト)ごとに区切った単位)をインスタンス化。
- 物理ディスクの位置にマッピングするために、論理ブロックにはファイル内での論理的な位置という概念が必要なため、論理ブロック番号もインスタンス化する。
- ファイルマネージャーはこの論理ブロックの論理的なオフセット位置で読み書きを行う
ディスクへの読み書き
- 論理ブロックのサイズと論理ブロック番号をもとに、ファイルオブジェクトのどこにそのバッファを書き込むかを算出する
計算例
論理ブロック番号5 × 400バイト = 論理的なオフセット2000バイト
- 算出したオフセット位置をもとにlseekシステムコールを発行し、ファイルポインタを該当オフセット位置に更新。1(排他制御必須)
- シークした位置にバッファを書き込むようwriteシステムコールを発行。
- 該当する位置のページキャッシュにバッファデータをコピー
- カーネルはファイルの管理情報(Linuxの場合はinode)を参照し、バッファの論理的な位置からディスクの物理的な位置を算出し、ディスクコントローラに対しそこにページキャッシュのこのデータを書き込むよう命令する。2
シーケンス図でコード上の流れを整理
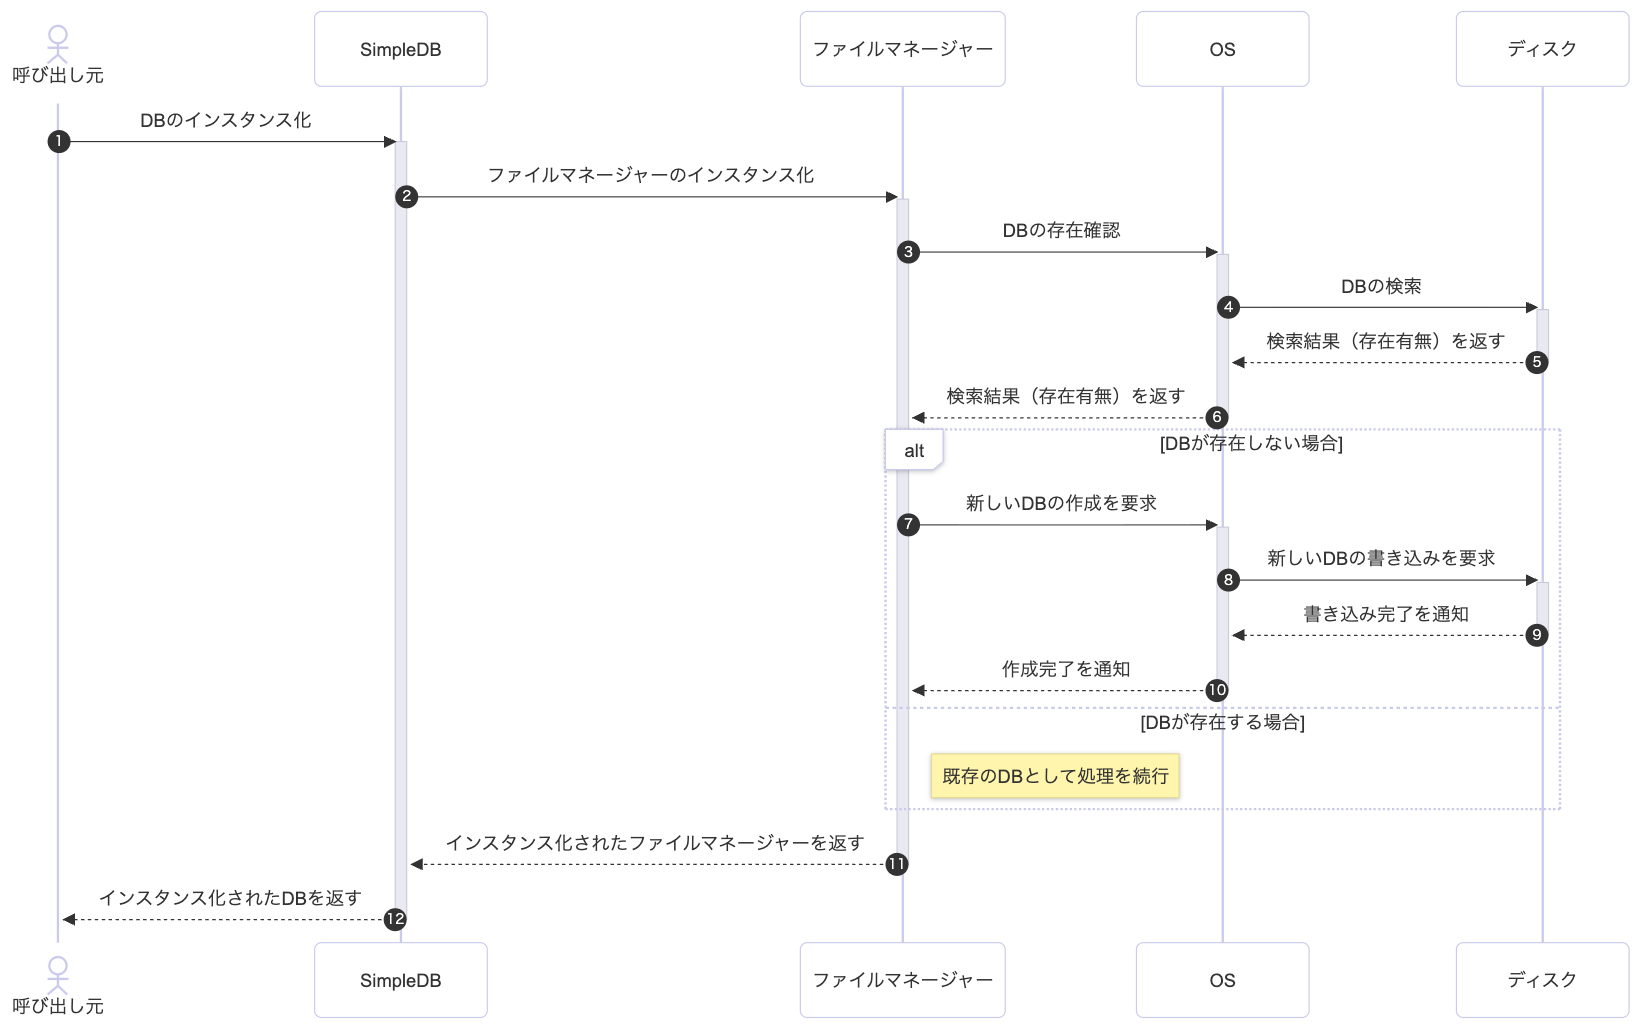
3章時点で実装したコードの処理の流れをシーケンス図で書いてみます。 ここでは「DBのインスタンス化」、「文字列データのバッファへの書き込み」、「バッファ(ページ)のディスクへの書き込み」を例に挙げます。
DBのインスタンス化
文字列データのバッファへの書き込み
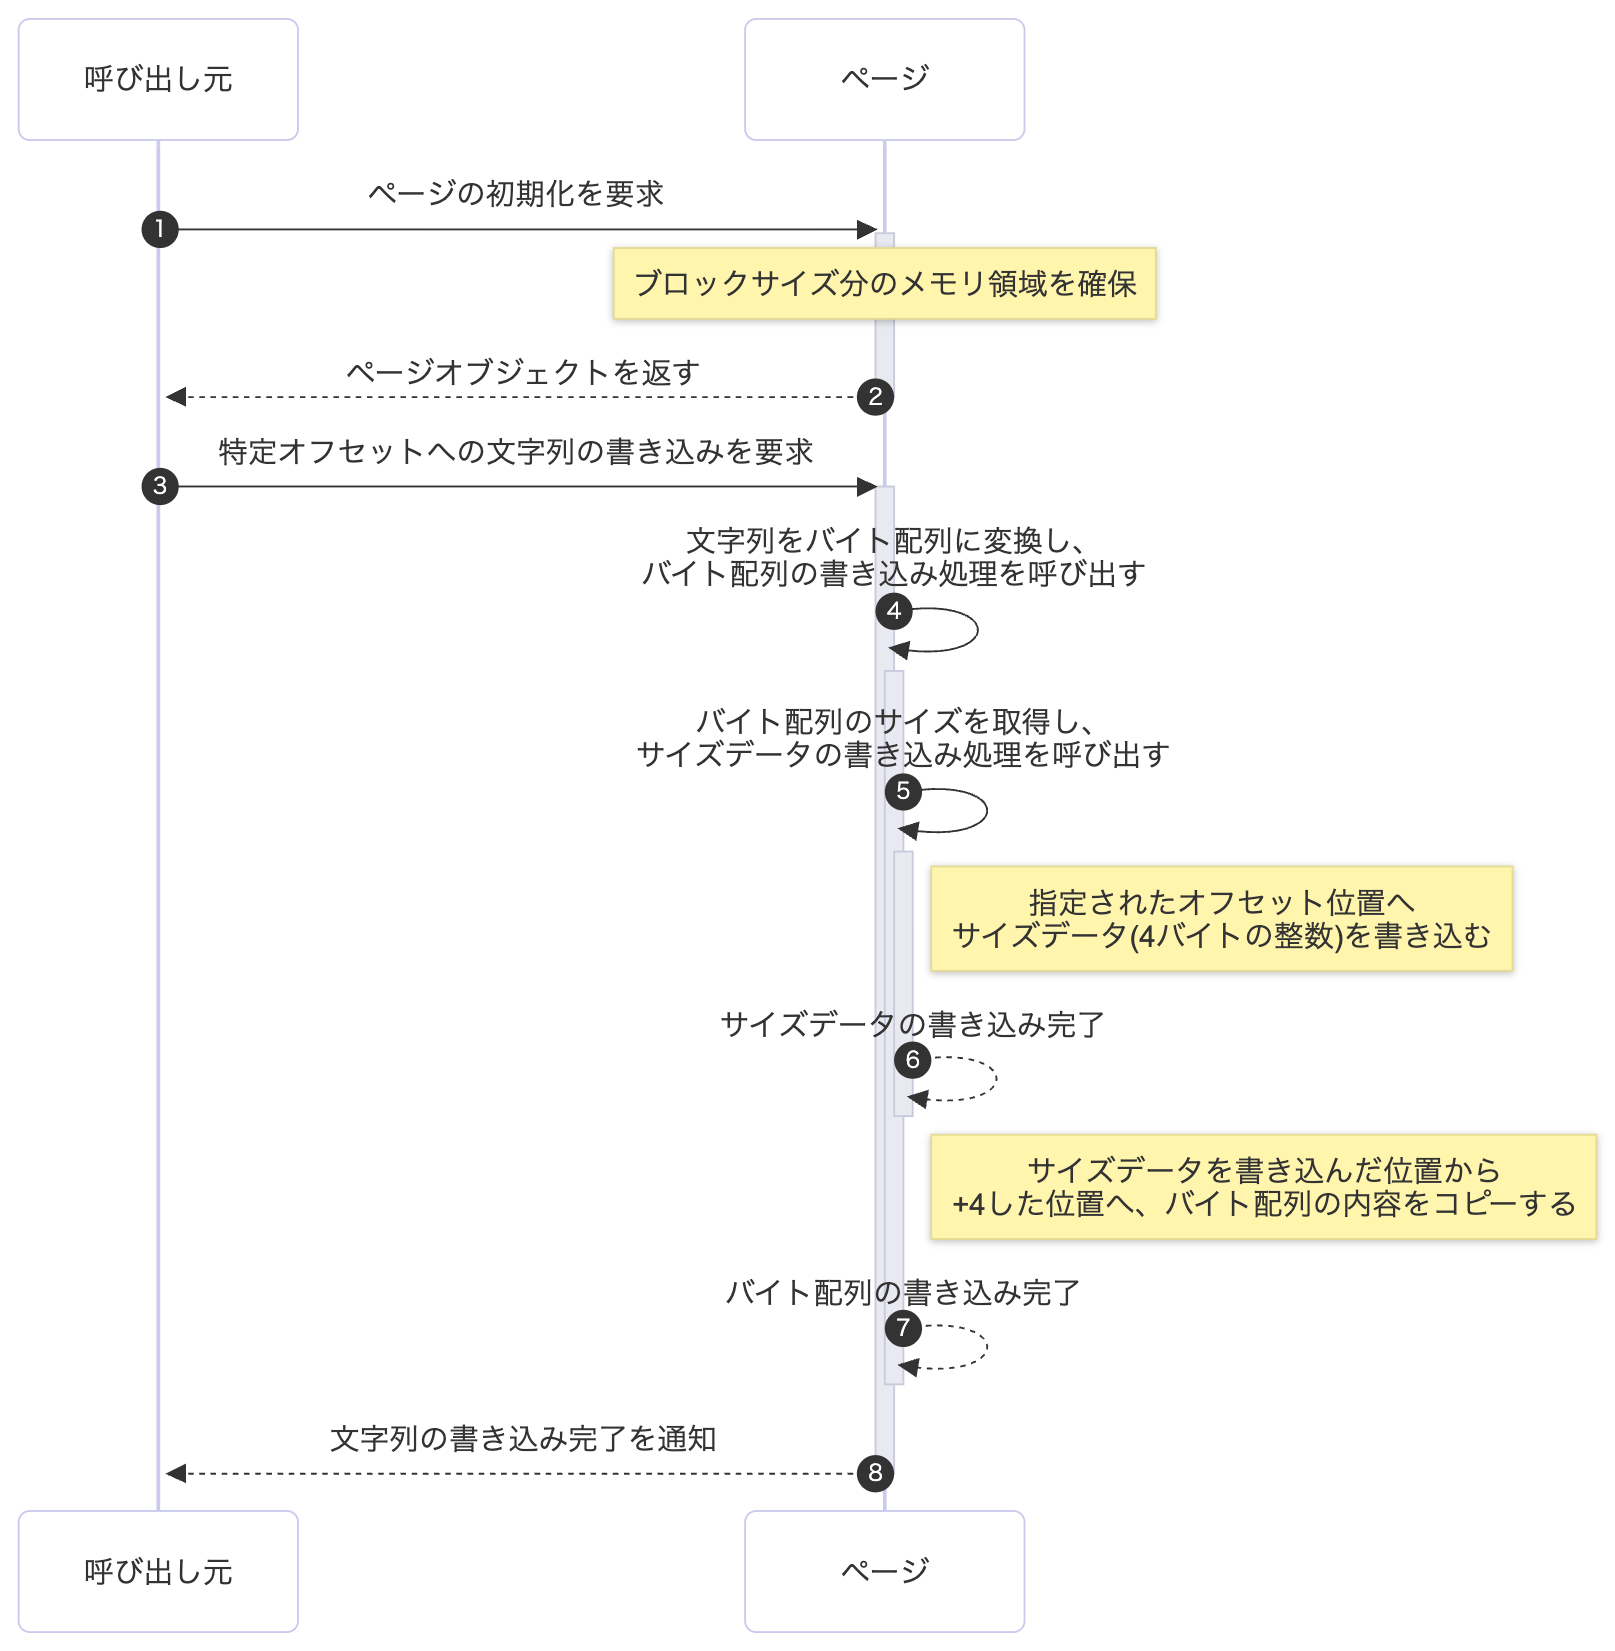 ①ページのブロックサイズはDBをインスタンス化したときに設定した値を引数に受け取ります。
バッファ(ページ)のディスクへの書き込み
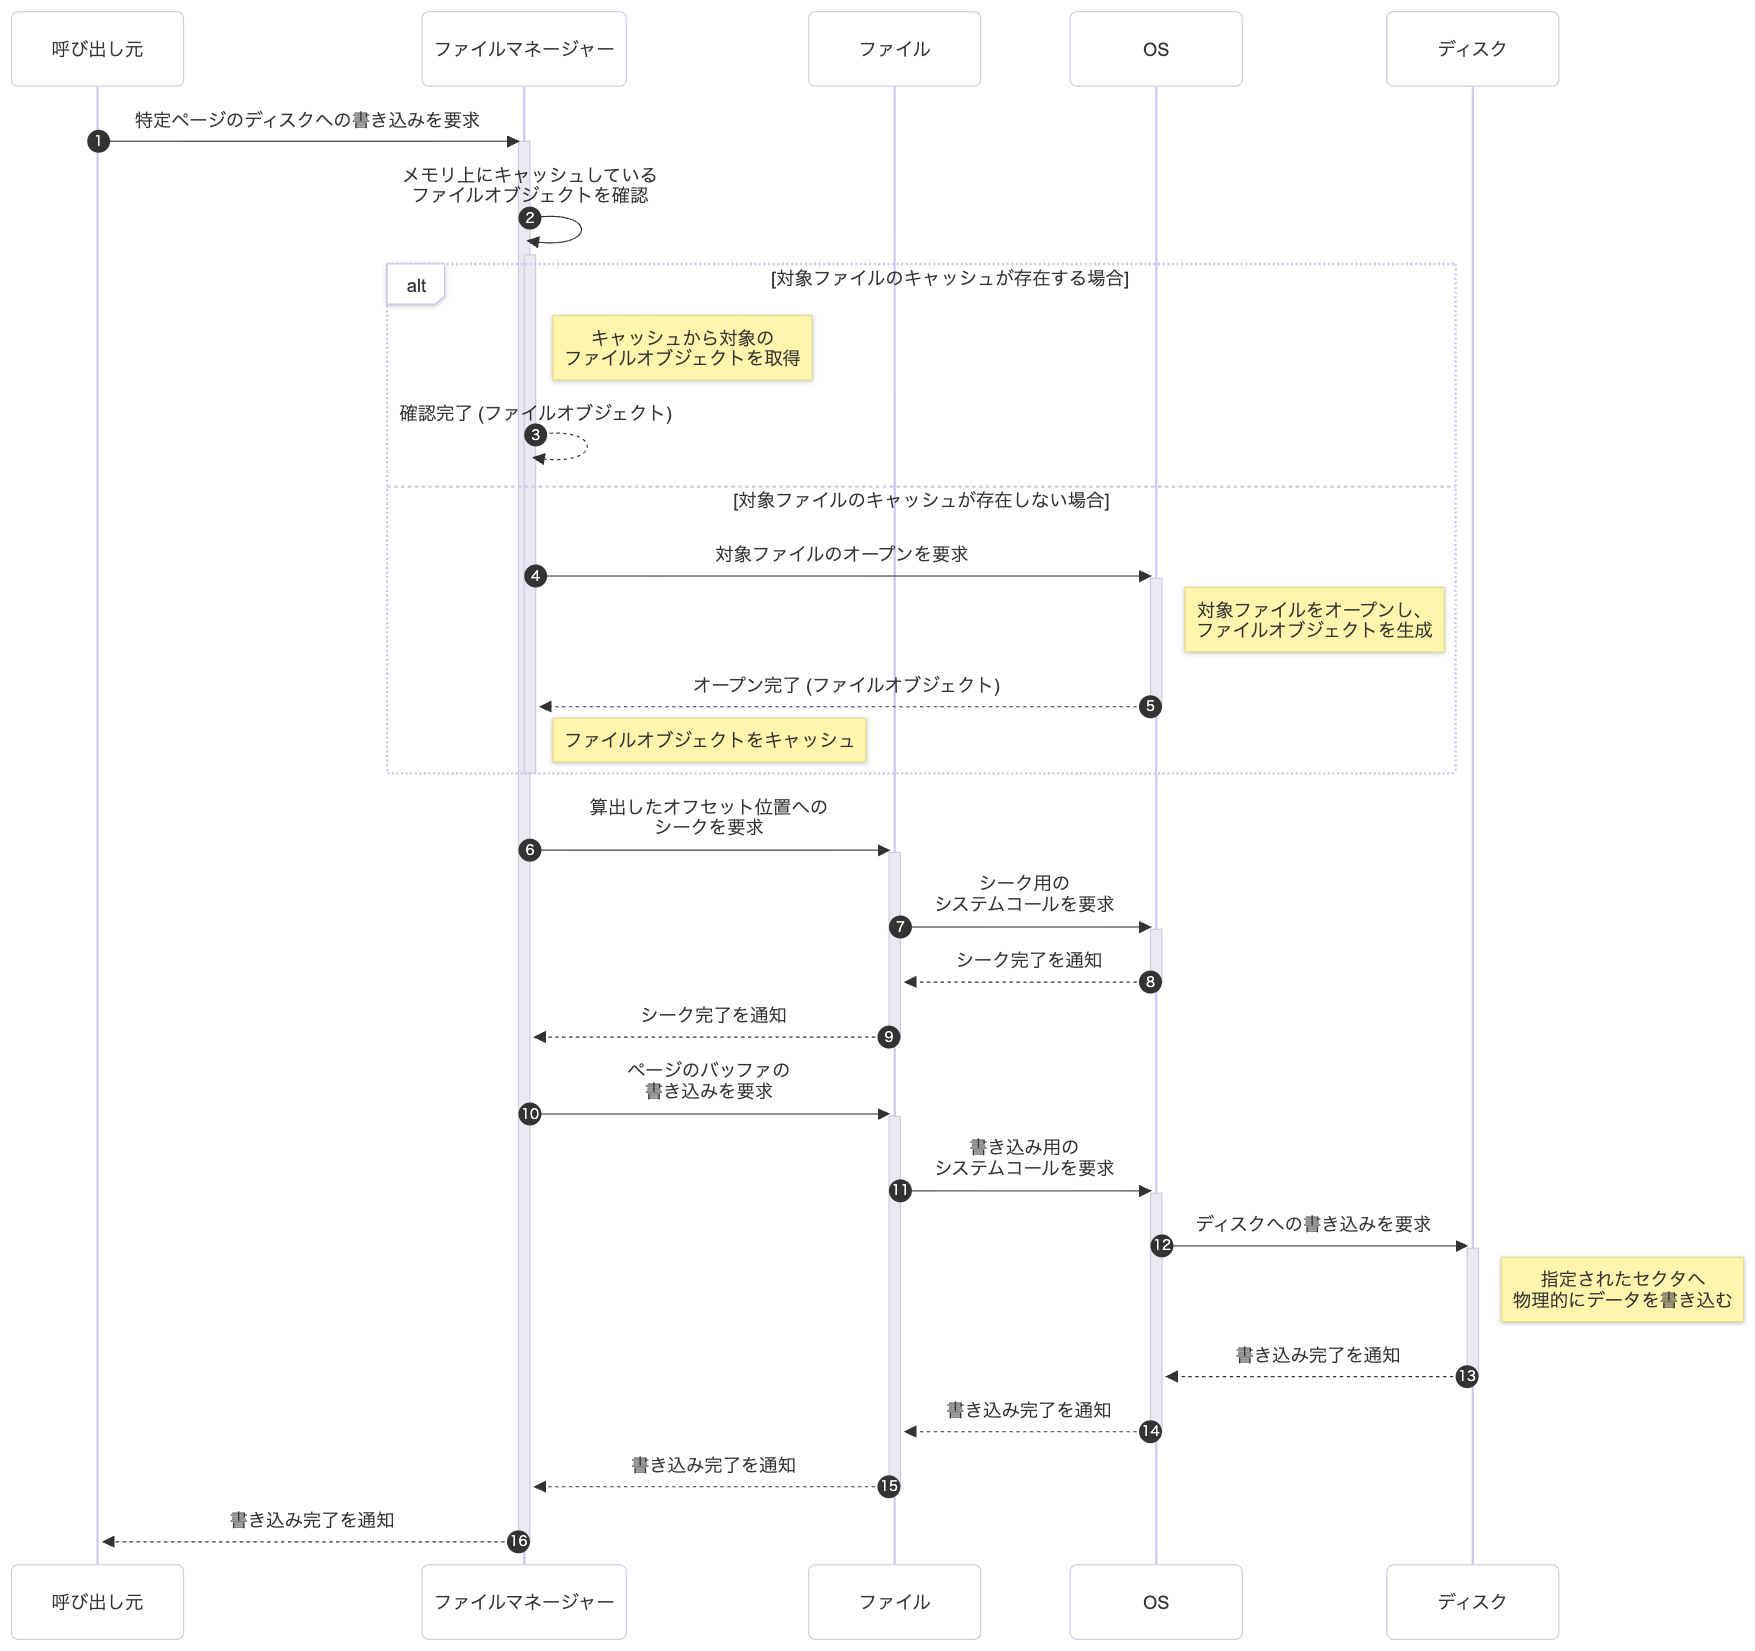 このシーケンス図の処理はこのように実装しました。
func (fm *FileManager) Write(blk *BlockId, p *Page) error {
	fm.mu.Lock()
	defer fm.mu.Unlock()

	f, err := fm.getFile(blk.FileName())
	if err != nil {
		return fmt.Errorf("fm.getFile: %w", err)
	}

	_, err = f.Seek(int64(blk.BlockNum())*int64(fm.blockSize), 0)
	if err != nil {
		return fmt.Errorf("f.Seek: %w", err)
	}

	_, err = f.Write(p.buffer)

	if err != nil {
		return fmt.Errorf("f.Write: %w", err)
	}

	return nil
}
- osパッケージのFile構造体に実装されているWriteメソッドは書き込むという動作しかしないため、このコードのようにあらかじめシークする必要があります。このようにシークと書き込みにラグがある実装の場合、以下のような問題を防ぐために排他制御する必要があります。3
- ファイルオブジェクトAに対し、スレッドAがシークしたあと、スレッドAが書き込む前にスレッドBがシークした場合、スレッドAの書き込みが意図しないオフセット位置に行われてしまう。
- ⑥でつかわれいてるオフセット位置は、前述した通り
論理ブロック番号*ブロックサイズで算出できます。 - ⑦では、物理的なシークではなく、論理的なオフセット位置へのシークが行われます。
迷った点
ページオブジェクトのバイト列への数値の読み書きを、リトルエンディアンとビッグエンディアンのどちらでするのが良いか(ここでは便宜上書き込み処理に焦点を当てます)
この書き込み処理に対し、書籍中のJavaコードではjava.nio.ByteBufferクラスのputIntメソッドが使われています。このメソッドは「指定された4バイトの整数をバイトデータに分割してバイト列に書き込む」という処理をしていて、エンディアンの指定は隠蔽されています。そして内部ではビッグエンディアンが使われています[1]。
Goで数値をバイトデータへ変換しバイト列に書き込む場合、encoding/binaryパッケージで用意されているPutUint32メソッドを使いますが、このメソッドはBigEndian、もしくはLittleEndianという変数から呼び出せるようになっています。つまり、Goの場合は開発者側でエンディアンを選ぶ必要があります。そのため、一応どちらが良いか考えてみたのですが、今回は両者の違いはあまり本質なテーマではない上に書籍での言及もないため、ひとまず以下の理由でビッグエンディアンにしました。
- 書籍にならう
- デバッグ時に見やすい(数値の並びが16進数の表記順のままなため)
最終的にこのように実装しました。
func (p *Page) GetInt(offset int) int32 {
	return int32(binary.BigEndian.Uint32(p.buffer[offset : offset+4]))
}

func (p *Page) SetInt(offset int, num int32) {
	binary.BigEndian.PutUint32(p.buffer[offset:offset+4], uint32(num))
}
さいごに
初めはDBに対してブラックボックス感が強く、本当に自作なんてできるのか不安でしたが、現代はAIのおかげで壁打ちし続ければいずれわかるという安心感があったため挑戦してみました。AIに聞けば大抵の技術的な疑問は解消できてしまうからこそ、限られた時間の中で本当に時間をかけて壁打ちすべきものは何なのかしっかり見極めていく必要があると感じました。
参考文献
1. Michael Kerrisk, Linuxプログラミングインタフェース, 千住 治郎訳, オライリー・ジャパン, 2012
lseekシステムコールの挙動について調べました(めっちゃ分厚い本なので人生のどこかでちゃんと読んでみたい)。
2. 渋川 よしき, Goならわかるシステムプログラミング第2版, ラムダノート, 2022
Goを用いたシステムプログラミングの基礎を学ぶ教材として参考にしました。
3. 武内 覚, [試して理解]Linuxのしくみ ―実験と図解で学ぶOS、仮想マシン、コンテナの基礎知識【増補改訂版】, 技術評論社, 2022
同じくシステムプログラミングの理解補助として活用しました。
脚注
OS上では、1つのファイルを複数のプロセスが同時に開くことができるため、カーネルが現在指しているファイルポインタに書き込むだけのsyscall.Write(Go)を使う場合は、都度適切なファイルポインタにシークする必要がある。もしシークしない場合、syscall.Writeはカーネルが覚えている前回のファイルポインタに書き込むことになるため意図しない書き込みが行われる可能性がある。 ↩︎
SimpleDBでは
os.O_SYNCフラグを立ててファイルを開いているため、ストレージデバイスにも同期的にデータが書き込まれます。 ↩︎WriteAtというメソッド(pwriteシステムコール)を使えばこの問題は回避できます。 ↩︎